
- TOP
- スニフアウトAIメディア
- RAG
- RAG の精度が上がらない原因と対策:切り分け方と手当ての順番
RAG の精度が上がらない原因と対策:切り分け方と手当ての順番
RAG の精度が上がらない原因は、元データ、質問、検索、回答生成のどこかにあります。手法を試す前に、外れた質問を 1 問ずつ 3 つの問いで振り分けると、どこを直せばよいかが決まります。原因ごとの症状と手当て、試す順番をまとめました。
目次
RAG の精度が上がらない原因は、元データ、利用者の質問(クエリ)、検索、回答の生成の 4 か所のどこかにあります。新しい手法を試す前に、外れた質問を 1 問ずつ「必要な情報が元データにあるか」「検索で拾えているか」「拾えているのに回答がずれていないか」の順に確かめ、原因の場所を特定してください。場所が分かれば、打つ手はかなり絞れます。どの場所にも当てはまらないときは、そもそも RAG に向かない質問を投げている可能性があります。
私の著書では、受けてきた精度の相談で最も大きな要因は「元データが RAG Ready ではないこと」だったと書きました。迷ったら、まず元データを疑ってください。この記事では、その切り分けの手順と、原因ごとの手当てを順に説明します。
初期の精度と、業務で求められる水準
最初から精度が出る RAG はほとんどありません。著書では、データやユースケースと合わないツールを選ぶと精度が 30% を切る企業も少なくないと書きました。株式会社スニフアウトの RAG技術研修 のページでも、ある企業の初期開発時の精度が 24% だった例を紹介しています。
一方で、業務で使うには 80% 程度以上がほしいところです。この差を埋める手法は山ほどありますが、どれから手を付けるか決められずに止まってしまう現場をたくさん見てきました。手法の名前から入らず、症状から原因の場所を当てるほうが早く進みます。
よくある症状と、まず疑う場所
| 症状 | まず疑う場所 |
|---|---|
| 文書に書いてあるのに「分かりません」と答える | 検索(チャンクの切り方、top-k)か、元データの読み取り |
| Excel や PowerPoint にある内容だけ答えられない | 元データ(表や図がテキストになっていない) |
| 開発中のテストでは当たるのに、現場の質問で外れる | 質問の言葉と、テストデータのつくり方 |
| 型番や製品名を含む質問で、別の製品の話をする | 検索(キーワード検索の併用、リランキング) |
| 去年の資料と今年の資料の内容が混ざる | 検索(年度などのメタデータで絞り込む) |
| 根拠のチャンクは合っているのに、答えがずれる | 生成(プロンプト、渡すチャンクのノイズ) |
| 要約や「すべて挙げて」に答えられない | RAG との相性(全文を渡す方法を検討) |
原因を切り分ける 3 つの問い
切り分けには準備が 2 つ要ります。テストデータの各質問に「理想の回答」と「本来使うべきチャンク(根拠の箇所)」を書いておくことと、システムが実際に参照したチャンクをログに残すことです。この 2 つがあれば、外れた質問を次の図のように 3 つの関門に通して振り分けられます。
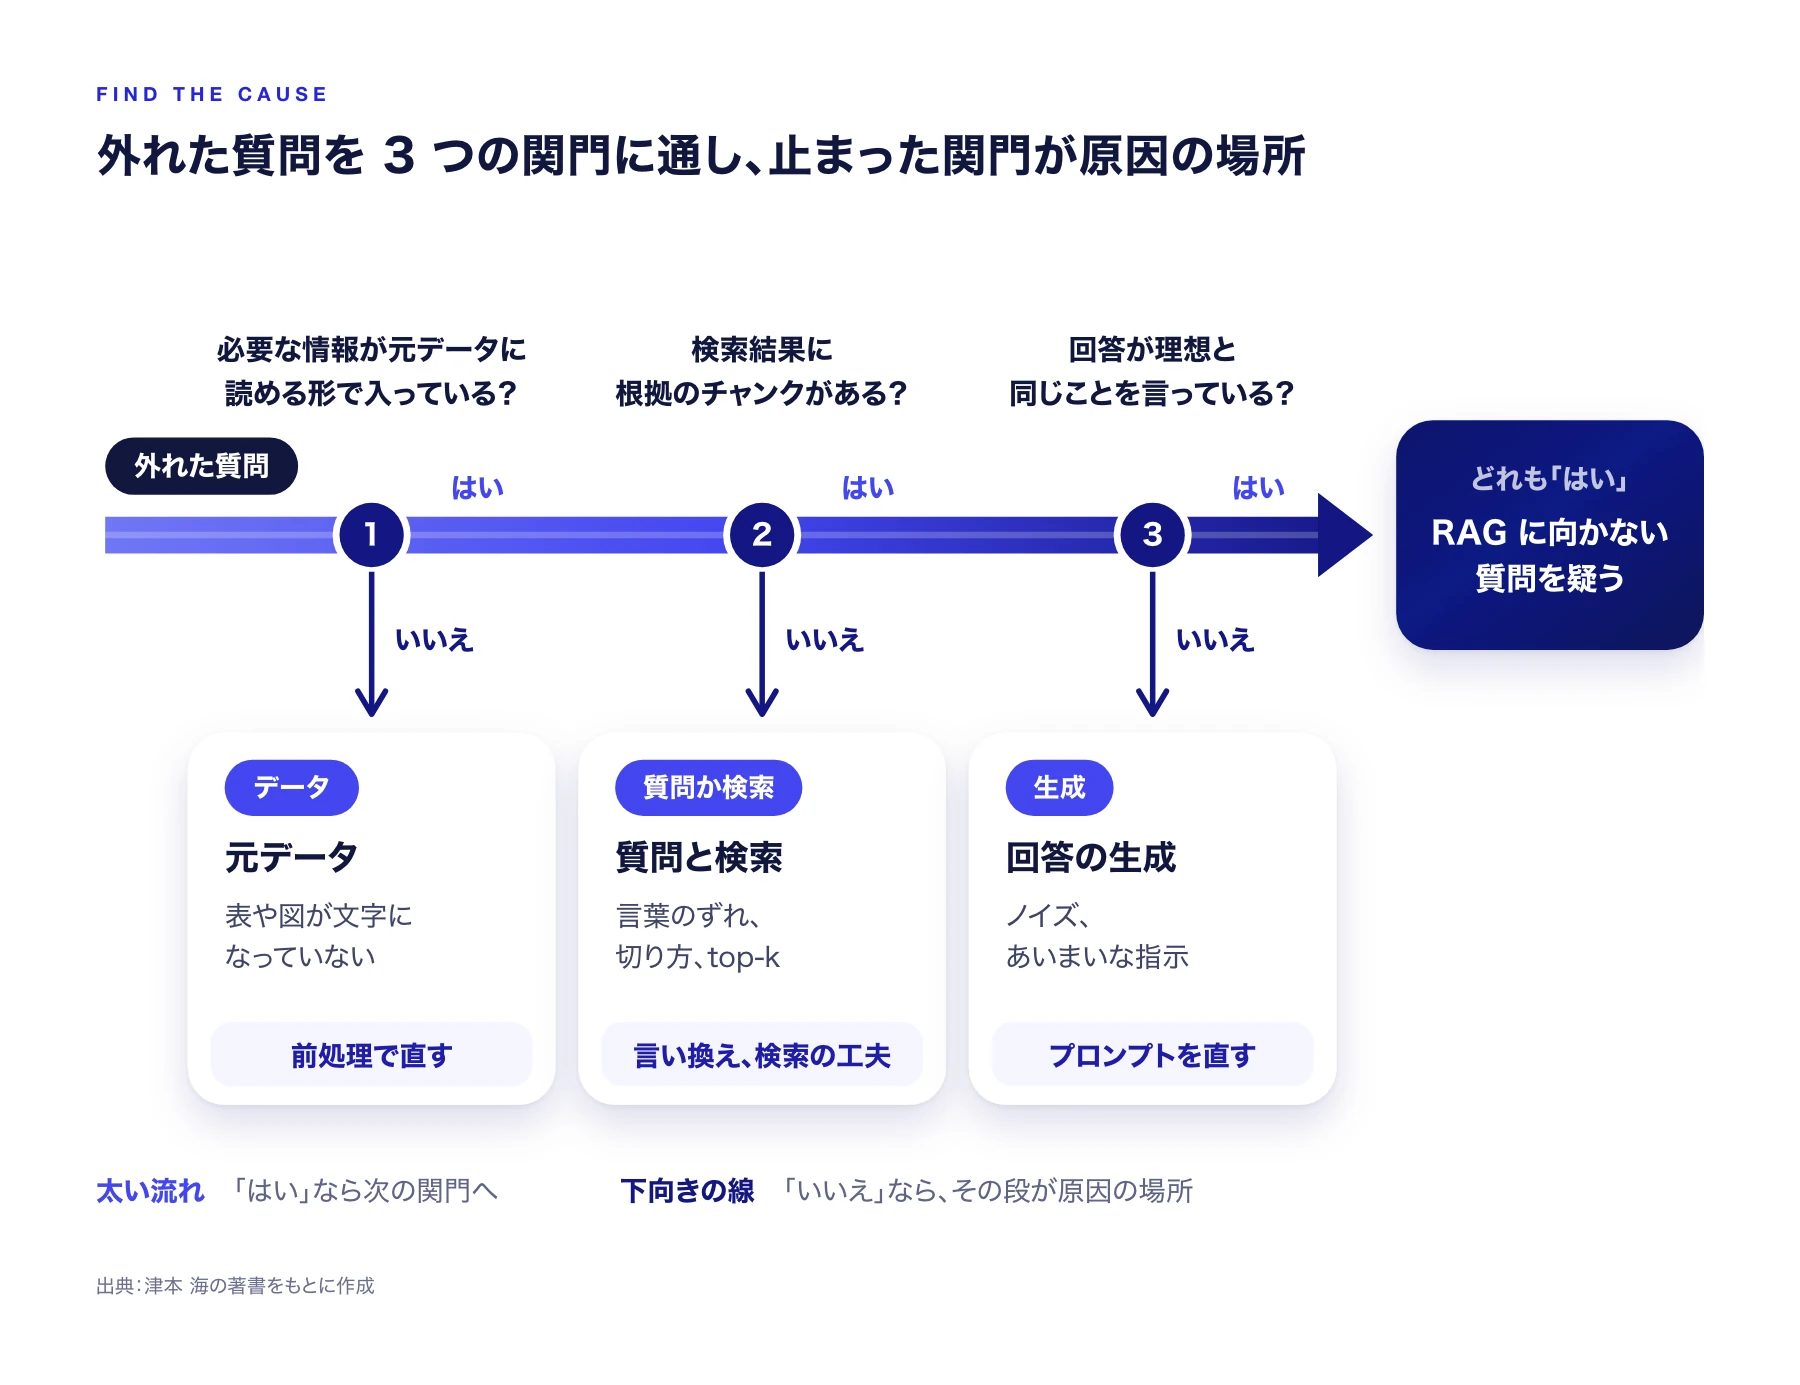
1 つ目の関門で止まればデータ、2 つ目なら質問か検索、3 つ目なら生成に原因があります。3 つとも通ってしまうなら、RAG に向かない質問を疑います(原因 5)。どの段で落ちた質問が多いかを数えれば、次に手を入れる段が決まります。テストデータのつくり方と採点の方法は「RAG の評価方法」で詳しく説明しています。
原因 1:RAG Ready ではない元データ
人が読みやすい資料は、AI にとって読みやすいとは限りません。Excel の罫線で描いたフローチャート、PowerPoint の図形の配置に込めた意味、PDF に貼られた説明図は、一般的な RAG に入れると多くの場合無視され、取り出せた文字だけが並びます。表は行と列の対応が崩れ、意味の通らないデータになることもあります。
必要な話が複数の資料に散らばっているのも、よくある原因です。ある業務を説明するのに「資料 A の 3 章」と「資料 B の 5 章」を両方読まないといけない構成だと、検索で片方しか拾えず、答えが欠けます。もっと手前の問題として、ベテランの頭の中にしかない知識は、そもそも文書になっていません。
手当ては、表や図をテキストに直し、見出しを整え、関連する話を 1 か所にまとめる前処理です。スニフアウトが提供する RAG Ready Converter のクローズドベータ版では、事前に用意したサンプル QA への正答率が 42% から 94% に上がり、基本的な RAG で取りこぼされずに扱えるデータの割合は 20% から 90% に増えました(いずれも同ツールの紹介ページに掲載)。形式ごとの具体的な直し方は「RAG のためのデータ前処理」にまとめています。
原因 2:短い質問、文書とずれた言葉
利用者は、裏側にどんな文書が入っているかを知らずに質問します。著書で挙げた例に、「Teams でどうやって連絡するんだっけ」という質問があります。この人が本当に知りたいのは Teams の使い方ではなく、案件を受注したときに誰へどう連絡するか、かもしれません。RAG は入力された文の意味に近いチャンクを探すので、Teams の操作説明を拾ってきてしまいます。
専門用語だらけのマニュアルに、詳しくない人が日常の言葉で質問するときも、言葉が合わずに外れます。厄介なのは、開発者がつくるテストデータはきれいな質問になりがちで、この種の外れを見逃すことです。私たちが支援してきた 40 社以上の RAG 開発でも、この見逃しは何度も起きています。
手当ては、質問をシステム側で補うことです。
- マルチクエリ:LLM に質問を何通りかに言い換えさせ、すべてで検索する
- 用語辞書による言い換え:一般的な言葉を、文書で使われている専門用語に直してから検索する
- HyDE:LLM に仮の回答を書かせ、その仮回答で検索する。質問文より回答文のほうが文書と言い回しが近いため
- 聞き返し:情報が足りない質問には、検索する前に利用者へ確認する(「RAG の精度を上げるクラリフィケーション」で詳しく扱っています)
原因 3:正しいチャンクを拾えない検索
検索の段は手を入れられる場所が最も多く、効く手当ても原因によって違います。
| 原因 | 手当て |
|---|---|
| チャンクが小さく、必要な説明が途中で切れている | チャンクを大きくする、境目を重ねる(オーバーラップ)、見出しや意味のまとまりで切る |
| 取り出す件数(top-k)が少ない | 件数を増やす。著書では 5 件以上を標準としている |
| 型番や固有名詞が意味の近さでは拾えない | キーワード検索と組み合わせるハイブリッド検索 |
| 候補は拾えているが、上位に関係の薄いものが並ぶ | リランキング(質問とチャンクを 1 組ずつ突き合わせて並べ直す) |
| 別の年度や別の部署の資料が混ざる | 年度や部署のメタデータを付け、先に範囲を絞る |
| 細かく探したいが、渡す文脈は広くしたい | 親子チャンク(小さい単位で探し、属する大きい単位を渡す) |
チャンクの大きさは悩みどころです。著書では、副業収入の報告ルールのように 200 字を超える説明を 200 字ずつに切ると、検索で一部を拾えても全体がそろわず、答えが欠けると説明しました。かといって大きくしすぎると、関係のない文章が混ざって回答がぶれ、費用も増えます。
チャンクを切ると、そのチャンク単体では何の話か分からなくなる問題もあります。Anthropic は、チャンクごとに文書全体の文脈を短く書き足してから索引をつくる方法(Contextual Retrieval)を 2024 年 9 月に公開しました。同社の検証では、上位 20 件に必要なチャンクが入らない失敗が、文脈の付与で 35%、キーワード検索との併用で 49%、リランキングまで加えると 67% 減ったそうです。
原因 4:根拠は合っているのにずれる回答
正しいチャンクを渡しているのに答えがずれるなら、生成の段の問題です。LLM は渡された文章を素直に使うので、関係の薄いチャンクが混ざっているとそれに引きずられます。関連度のスコアが低いチャンクを足切りする、複数のチャンクを要約してから渡す、といった手当てが効きます。
プロンプトも見直します。著書で紹介したプロンプトの例では、「コンテキストに書かれていないことは推測せず、分かりませんと回答する」と明記しています。回答の形を表や決まった項目に固定しておくと、出力のばらつきも比べやすくなります。
金額のように一つの誤りも許されない回答は、そもそも LLM に文章を書かせない設計にします。人が確認済みの回答文や公式ページの URL を用意しておき、どれを出すかの判断だけを LLM に任せる方法です。
原因 5:RAG に向かない質問
文書全体の要約、条件に当てはまる項目の列挙、売上の集計のような質問は、RAG の仕組みと相性がよくありません。RAG は質問に近い一部しか読まないからです。要約は全文を LLM に渡す方法、集計は LLM にコードを書かせて計算する方法のほうが確実です。
質問の種類が混ざるシステムでは、入口で質問を分類して、RAG、全文の読み込み、計算などに振り分ける設計にします。こうした振り分けや再検索を AI エージェントに判断させる構成は、Agentic RAG と呼ばれます。
手当てを試す順番
手当ては、RAG のどの段に手を入れるかで分けて考えます。ここまでの内容を段ごとにまとめると、次のとおりです。
| 段 | 主な手当て |
|---|---|
| データの前処理 | 表や図のテキスト化、見出しの整理、関連する話の集約、年度や部署のタグ、チャンクの切り方の変更 |
| 質問の拡張 | 言い換えて複数回検索、辞書で専門用語に直す、仮の回答で検索(HyDE)、あいまいなら聞き返す |
| 検索の拡張 | top-k の調整、ハイブリッド検索、リランキング、メタデータでの絞り込み、親子チャンク |
| 回答生成の改善 | 推測しない指示、出力形式の固定、スコアの低い候補の除外、用意した回答から選ばせる |
| パイプライン全体 | 入口で質問を振り分ける、ルールベースの処理と組み合わせる、Agentic RAG にする |
| RAG 以外の方法 | 要約は全文を渡す、集計はコードで計算する、構成の複雑な文書は目次をたどる方式(PageIndex)も候補 |
同じ段の中では、実装の手間が小さいものから試すのが基本です。段をまたぐ順番は、次を目安にしてください。
- テストデータとログをそろえる。これが無いと、何を変えても効いたかどうか分からない
- 元データを直す。市販のツールで中のロジックを変えられない場合でも、入れるデータは自分たちで直せる
- 質問を補う。言い換えや辞書は、検索の仕組みを変えずに試せる
- 検索を変える。top-k やチャンクサイズの調整から始め、ハイブリッド検索、リランキング、メタデータへ進む
- 生成を直す。プロンプトと出力形式を見直す
- パイプライン全体を組み替える。質問の振り分けや、Agentic RAG にする
1 回に変えるのは 1 か所だけにして、同じテストデータで前後の数字を比べてください。2 つ同時に変えると、どちらが効いたのか分からなくなります。
施策の選び方そのものを社内で判断できるようにしたい場合は、テストデータの準備から低精度の原因の特定、施策の選び方までを扱う RAG技術研修 を用意しています。
まとめ
- 精度が上がらない原因は、元データ、質問、検索、生成の 4 か所のどこかにある。迷ったらまず元データを疑う
- 外れた質問を「元データにあるか」「検索で拾えたか」「回答が合っているか」の 3 つの問いで振り分ける
- そのために、テストデータに理想の回答と根拠の箇所を書き、参照したチャンクをログに残す
- 手当ては段ごとに選び、手間の小さいものから 1 つずつ試して数字で比べる
よくある質問
RAG の精度が低いとき、最初に何を確かめればいいですか?
チャンクサイズは何文字にすればいいですか?
LLM を新しいモデルに替えれば精度は上がりますか?
精度は何 % あれば業務で使えますか?
この記事に関連するサービス
東京大学大学院 複雑理工学専攻卒業。理論物理学・ヒューマンインターフェースを専門とし、大手化粧品メーカー・ゲーム会社で AI/機械学習の開発に従事。2022年11月に株式会社スニフアウトを創業。RAG と AI エージェントの解説書を執筆している。
あわせて読みたい記事
 RAG(検索拡張生成)は、LLM が答える前に社内文書を検索し、見つけた一部をプロンプトに入れて回答させる仕組みです。モデルの再学習とは別物です。4 つの手順、生成 AI 単体との違い、向く業務と向かない業務を図で説明します。
 RAG の評価は、現場の人が入れる質問と理想の回答の組で正答率を出し、外れた原因を検索、生成、データに分けるところまで行います。質問集の項目と質問の種類、RAGAS の指標、LLM-as-a-Judge の注意点を説明します。
 RAG のデータ前処理は、Excel や PDF、PowerPoint、画像の情報を、検索で見つかり LLM が読み違えないテキストに直す作業です。形式ごとの崩れと直し方、チャンク分割までの 6 つの手順、自動化の考え方をまとめました。