
- TOP
- スニフアウトAIメディア
- RAG
- RAG の評価方法:評価用の質問集のつくり方、指標、改善の回し方
RAG の評価方法:評価用の質問集のつくり方、指標、改善の回し方
RAG の評価は、現場の人が入れる質問と理想の回答の組で正答率を出し、外れた原因を検索、生成、データに分けるところまで行います。質問集の項目と質問の種類、RAGAS の指標、LLM-as-a-Judge の注意点を説明します。
RAG の評価とは、現場の人が実際に入れそうな質問と、それに対する理想の回答の組(テストデータ)を用意し、システムの回答と突き合わせて正答率を出すことです。ただし正答率だけでは、何を直せばよいかが分かりません。各質問でシステムが参照したチャンクを記録し、外れた原因が検索、生成、元データのどこにあるかまで分けて、はじめて改善に使える評価になります。
私の著書では、実際の利用者の振る舞いに沿った網羅的なテストデータさえ準備できれば、精度改善の準備は 8 割終わったと書きました。この記事では、その質問集のつくり方と、採点、結果の読み方、改善の回し方を順に説明します。
評価の全体の流れ
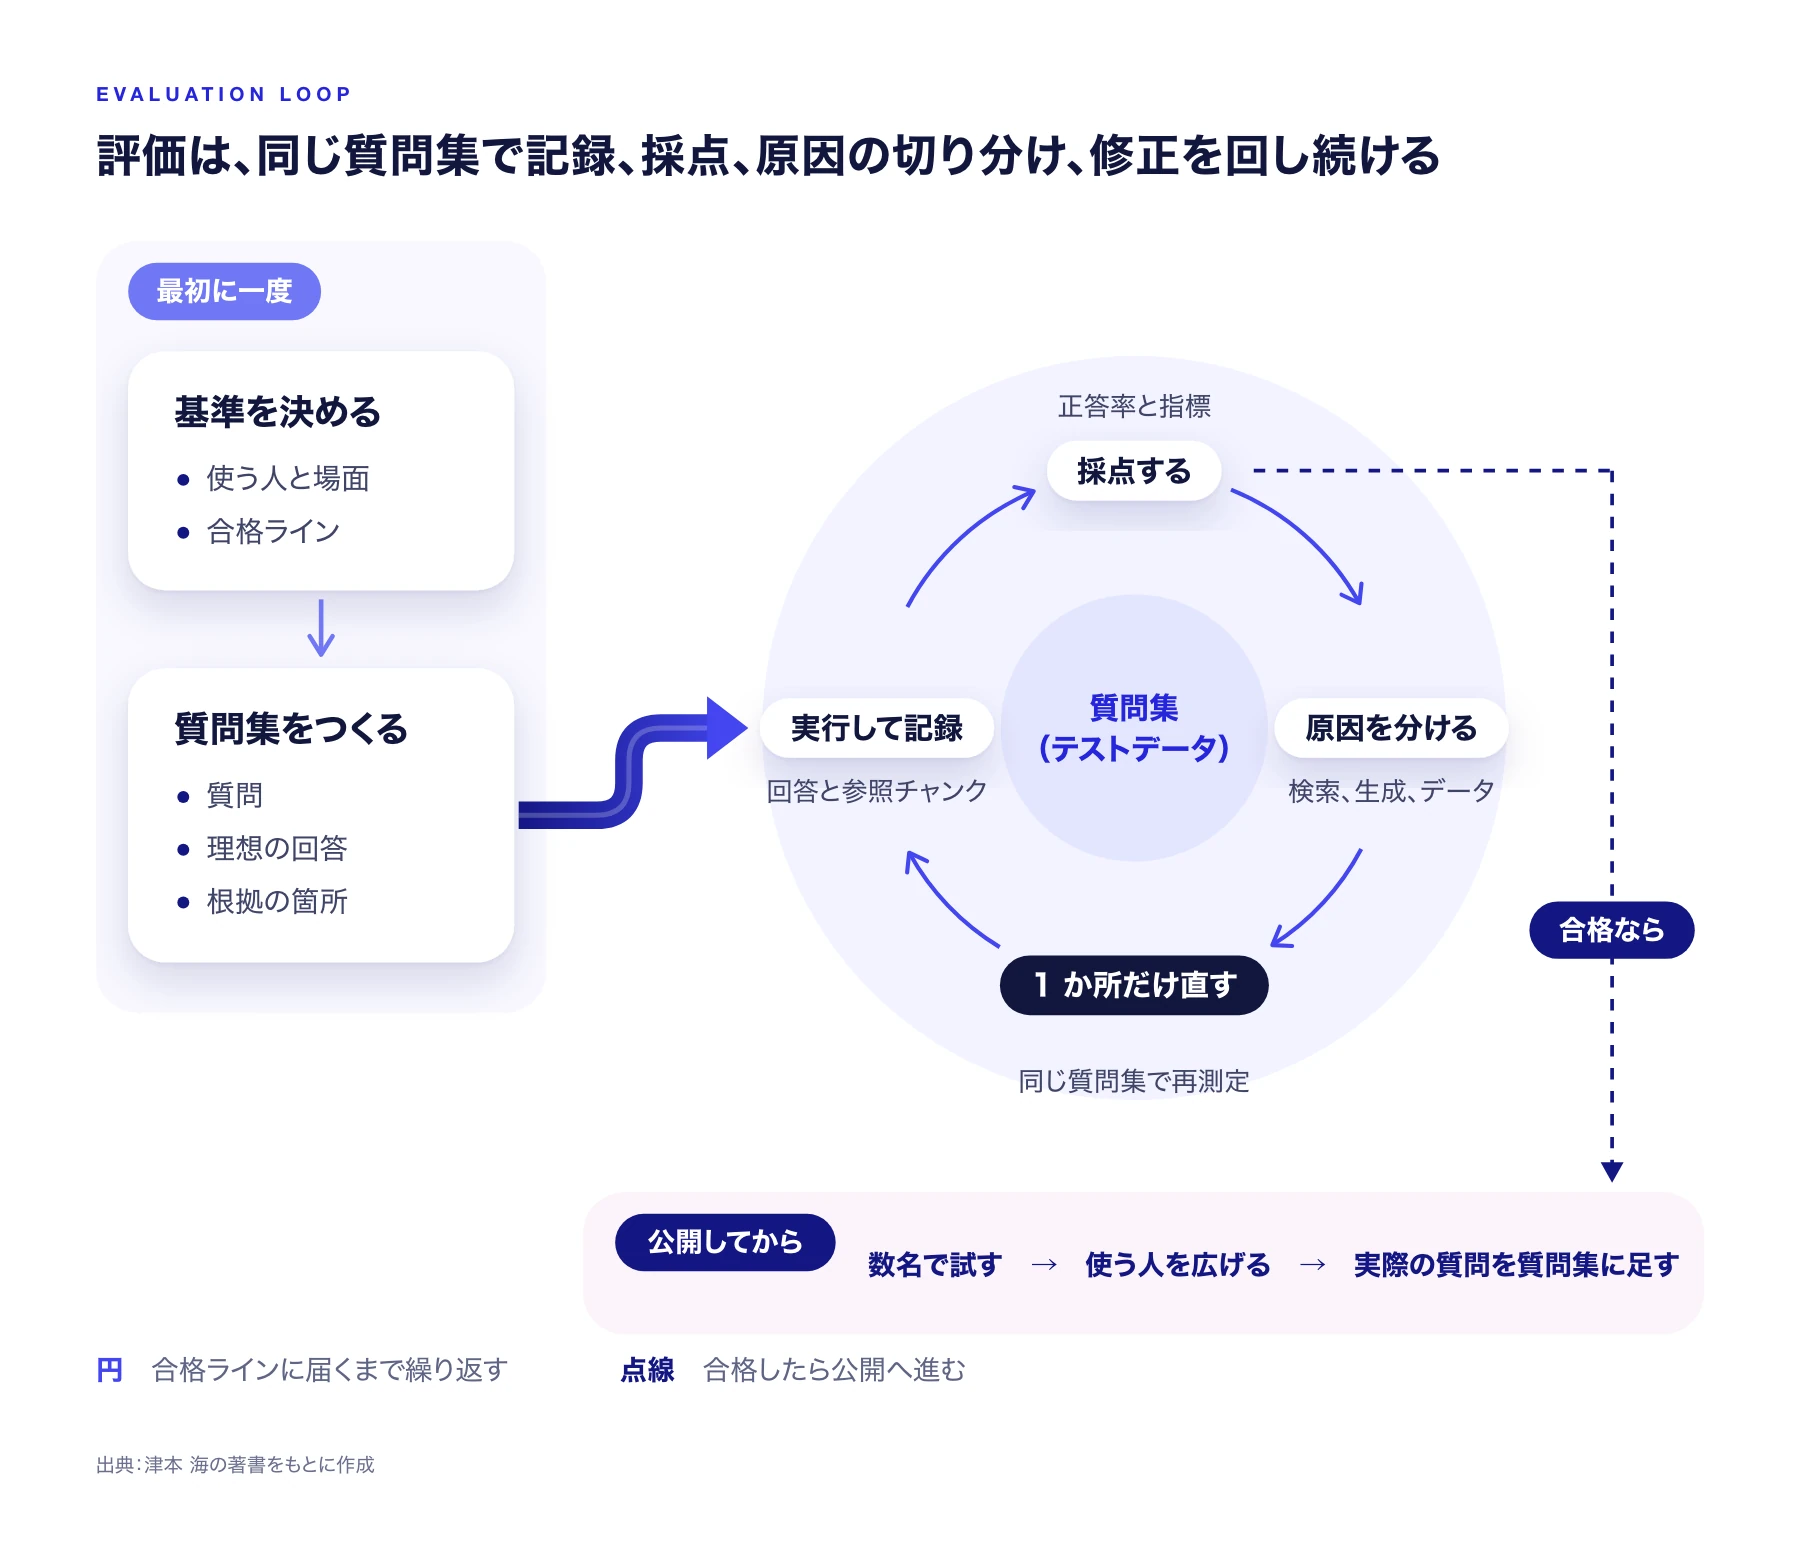
基準と質問集は最初に一度つくり、あとは同じ質問集を使って「実行して記録、採点、原因の切り分け、1 か所だけ直す」を合格ラインに届くまで回します。合格したら数名で試してから公開し、公開後は実際に入力された質問を質問集に足し続けます。
合格ラインの決め方
合格ラインは、誰がどんな場面で使うかで変わります。著書では、業務で使うには 80% 程度以上が目安だとしました。お客様に直接見せる回答や金額の回答は、これより厳しく見る必要があります。
同じ RAG でも、使う人によって精度の見え方が変わる点にも注意してください。著書で挙げた例では、専門的な文書を検索対象にした RAG に、その分野に詳しい人が専門用語で質問すれば検索はよく当たります。同じシステムに詳しくない人が日常の言葉で質問すると、精度は下がります。誰を想定するかを決めないまま測った数字は、あまり当てになりません。
想定外の質問への振る舞いも、ここで決めておきます。業務に関係のない質問に「対象の文書に記載がないので答えられません」と返すのか、一般的な LLM として答えさせるのかで、正解の書き方が変わるからです。
評価用の質問集(テストデータ)のつくり方
質問集は表計算ソフトの 1 行に 1 問を書きます。最低限、次の項目をそろえてください。
| 項目 | 書く内容 | 何に使うか |
|---|---|---|
| 質問 | 利用者が実際に入れそうな文。言葉づかいも現場のまま | 実行する入力 |
| 理想の回答 | 回答に含まれていてほしい中身 | 回答の採点 |
| 根拠の箇所 | 答えの根拠になる文書とその箇所(理想のチャンク) | 検索が当たったかの判定 |
| 質問の種類 | 下の表の分類 | 弱い種類の発見 |
| 想定する利用者 | 新人、専門家、お客様など | 合格ラインの確認 |
いちばん注意すべきは質問のリアリティです。開発者が質問をつくると、検索対象の文書の中身を知っているため、答えやすい質問ばかりになりがちです。社内のテスト(オフラインテスト)では精度が高かったのに、実際に使ってもらう段階(オンラインテスト)で外れが続出する原因の多くは、ここにあります。
そこで、次の種類の質問を意識して混ぜます。
| 質問の種類 | 例 | 確かめたいこと |
|---|---|---|
| 文書と同じ言葉の質問 | 有給休暇の繰り越しの規定は? | 基本の検索が当たるか |
| 日常の言葉の質問 | 休みって来年に持ち越せる? | 言葉のずれに耐えられるか |
| 短く、情報が足りない質問 | 有給のことを教えて | 聞き返しや補い方が適切か |
| 複数の箇所を組み合わせる質問 | 異動したら有給の残りはどうなる? | 離れた情報を両方拾えるか |
| 文書に答えがない質問 | 社員食堂の今日のメニューは? | 作り話をせず、答えられないと返すか |
| 文書の全体を問う質問 | この規程で改訂されたところを全部挙げて | RAG 以外の方法に切り替えるべきか |
| 数値や金額の質問 | 出張の日当はいくら? | 数字の取り違えがないか |
例の質問はこの記事のための説明用で、どの質問が必要かは扱う文書と利用者で決まります。質問は、現場の担当者に普段の言葉で書いてもらうのが確実です。
件数の目安として、株式会社スニフアウトの RAG技術研修 のページでは、評価に 200 件以上のデータが必要になった企業の事例を紹介しています。件数を増やす前に、上の種類が偏りなく入っているかを確かめてください。
実行するときに残すログ
採点のために、各質問について次を記録します。
- システムの回答
- 実際に参照したチャンク(どの文書のどの箇所か、検索のスコア)
- 質問集に書いた根拠の箇所と、2 が一致しているか
著書でも強調したとおり、回答の正誤だけを記録していると、外れたときに原因を特定できません。参照したチャンクのログは、評価のために後から足すのではなく、最初から出るように作っておきます。
採点に使う指標
まず見るのは、理想の回答と同じことを伝えている回答の割合(正答率)です。言い回しが違っても、伝えている中身が同じなら正解とします。
そのうえで、検索と生成のどちらで落ちたかを見る指標を使います。RAG の評価用のオープンソースライブラリ RAGAS には、代表的な指標として次のものがあります。
| 指標 | 測ること | 低いときに疑う場所 |
|---|---|---|
| Faithfulness(忠実性) | 回答の主張のうち、参照した文書にもとづくものの割合 | 生成。文書にない情報を作っている |
| Answer Relevancy(回答の関連性。Response Relevancy とも表記) | 回答が質問に答えているか | 生成。的外れ、回りくどい、足りない |
| Context Recall(文脈の再現率) | 理想の回答に必要な情報が、検索結果にどれだけ入っているか | 検索。チャンクの切り方や top-k |
| Context Precision(文脈の適合率) | 検索結果に関係のない情報が混ざっていないか、関係する文書が上位にあるか | 検索。リランキングの導入 |
著書では、Faithfulness の例として、文書に「納期は 3 週間」とあるのに「2 週間でお届けできます」と答えるとスコアが下がると説明しました。Context Recall が低いなら直す先は検索の側、Faithfulness が低いなら生成の側、というように、指標ごとに手を入れる場所が分かれます。
採点の自動化と、その注意点
理想の回答とシステムの回答が同じ意図かどうかを、人が 1 問ずつ判定すると時間がかかります。そこで、採点そのものを LLM に任せる LLM-as-a-Judge が広く使われています。
この手法を検証した Zheng らの論文(2023 年)では、GPT-4 による判定が人の判断と 80% 以上一致し、人同士の一致率と同じ水準だったと報告しています。同じ論文は、回答を並べる順番に判定が引きずられる、長い回答を高く評価しがち、自分が生成したものに近い回答をひいきする、といった偏りも挙げています。
全部を LLM に任せきりにせず、一部の質問は人も採点して、LLM の判定と食い違いがないかを確かめてください。食い違いが多いなら、採点用のプロンプトに判定の基準を具体的に書き足します。
結果の読み方
採点が終わったら、外れた質問を「根拠のチャンクを拾えたか」と「回答が理想と合ったか」の 2 つで分けます。
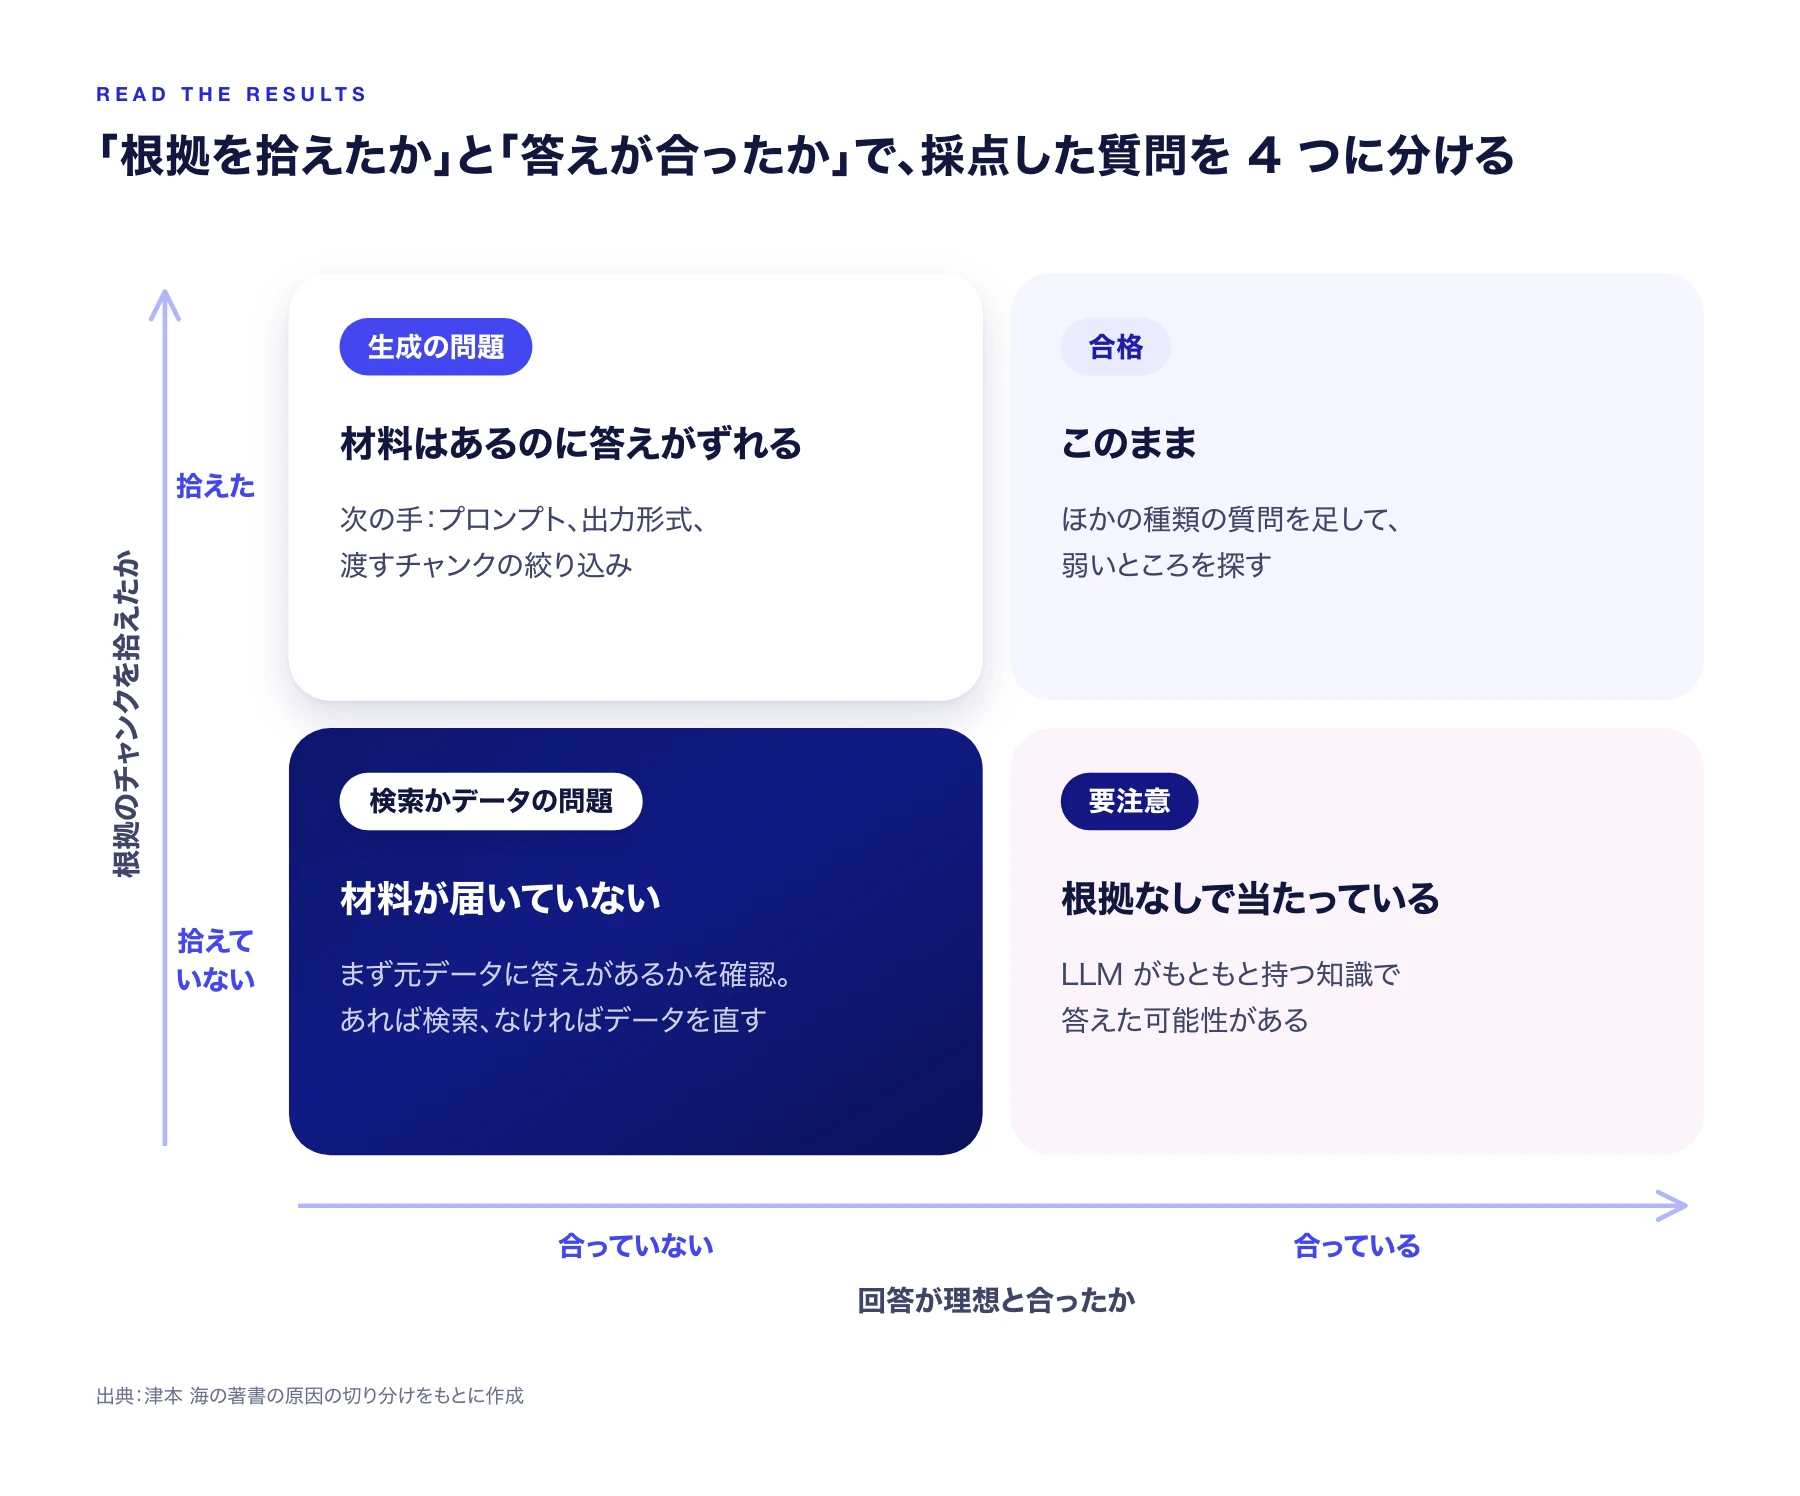
左上は生成、左下は検索かデータに原因があります。右下の「根拠なしで当たっている」は見落としやすい区分です。社内の文書を参照せずに、LLM がもともと持つ一般的な知識で答えた可能性があり、社内固有の質問では同じようには当たりません。
区分ごとの件数を数えれば、次に手を入れる場所が決まります。原因ごとの手当ては「RAG の精度が上がらない原因と対策」にまとめています。
改善の回し方
改善は、1 回に 1 か所だけ変えて、同じ質問集で測り直すのが基本です。チャンクサイズとプロンプトを同時に変えると、上がっても下がっても、どちらが効いたのか分かりません。施策ごとに正答率と区分ごとの件数を、次のような表に残しておくと、次の判断が速くなります。
| 版 | 変えたこと | 正答率 | 検索で落ちた件数 | 生成で落ちた件数 |
|---|---|---|---|---|
| v1 | 初期構成 | (測定値) | (件数) | (件数) |
| v2 | top-k を増やした | (測定値) | (件数) | (件数) |
| v3 | ハイブリッド検索にした | (測定値) | (件数) | (件数) |
合格ラインに届いても、いきなり全社に公開しないでください。著書では、一度でも期待外れの回答を見た利用者は使わなくなりがちなので、RAG の仕組みと精度向上の難しさを分かっている数名で先に試すことを勧めています。そこで実用に足ると確かめてから、使う人を広げます。
公開した後は、実際に入力された質問がいちばんの評価材料です。ログから外れた質問を拾い、理想の回答を書いて質問集に足していくと、質問集が現場の使い方に近づいていきます。
まとめ
- RAG の評価は、質問と理想の回答の組で正答率を出し、外れた原因を検索、生成、データに分けるところまで行う
- 質問集には、日常の言葉、情報不足、複数箇所、答えのない質問などを混ぜ、現場の人に書いてもらう
- 参照したチャンクのログを最初から残し、RAGAS の指標などで検索と生成のどちらが弱いかを見る
- LLM-as-a-Judge は速いが偏りがあるので、一部は人が採点して確かめる
- 1 回に 1 か所だけ変えて測り直し、公開後は実際の質問を質問集に足し続ける
テストデータの準備から低精度の原因の特定、施策の選び方までを、ハンズオンを含めて学べる場として RAG技術研修 を用意しています。
よくある質問
RAG の評価用の質問は何件用意すればいいですか?
理想の回答(正解データ)は誰がつくるべきですか?
LLM-as-a-Judge だけで採点してよいですか?
RAGAS とは何ですか?
この記事に関連するサービス
東京大学大学院 複雑理工学専攻卒業。理論物理学・ヒューマンインターフェースを専門とし、大手化粧品メーカー・ゲーム会社で AI/機械学習の開発に従事。2022年11月に株式会社スニフアウトを創業。RAG と AI エージェントの解説書を執筆している。
あわせて読みたい記事
 RAG(検索拡張生成)は、LLM が答える前に社内文書を検索し、見つけた一部をプロンプトに入れて回答させる仕組みです。モデルの再学習とは別物です。4 つの手順、生成 AI 単体との違い、向く業務と向かない業務を図で説明します。
 RAG のデータ前処理は、Excel や PDF、PowerPoint、画像の情報を、検索で見つかり LLM が読み違えないテキストに直す作業です。形式ごとの崩れと直し方、チャンク分割までの 6 つの手順、自動化の考え方をまとめました。
 クラリフィケーションは、RAG への質問があいまいで答えが一つに決まらないとき、AI がユーザーに聞き返して条件を補ってもらう手法です。いつ聞き返すか、どう聞くか、効果の測り方までを解説します。