
- TOP
- スニフアウトAIメディア
- RAG
- RAG とは?検索拡張生成の仕組みと生成 AI 単体との違い、向いている業務
RAG とは?検索拡張生成の仕組みと生成 AI 単体との違い、向いている業務
RAG(検索拡張生成)は、LLM が答える前に社内文書を検索し、見つけた一部をプロンプトに入れて回答させる仕組みです。モデルの再学習とは別物です。4 つの手順、生成 AI 単体との違い、向く業務と向かない業務を図で説明します。
RAG(Retrieval-Augmented Generation、検索拡張生成)とは、LLM が回答をつくる前に社内文書などを検索し、質問に関係する一部をプロンプトに入れてから答えさせる仕組みです。LLM に新しい知識を学習させるのではなく、質問のたびに必要な資料を手元に置いて答えさせます。そのため、LLM が学習していない社内規程や製品マニュアルについても、その文書にもとづいた回答ができます。
名前は、2020 年に Patrick Lewis らが発表した論文「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」(NeurIPS 2020)から来ています。ここでは、私の著書の内容をもとに、仕組みと向き不向きを説明します。
RAG という言葉の意味
3 つの英単語を分けると、RAG が何をしているかがそのまま分かります。
| 語 | 日本語 | RAG の中でやること |
|---|---|---|
| Retrieval | 検索 | 質問に関係しそうな文書の一部を探す |
| Augmented | 拡張 | 探した文書をプロンプトに足し、LLM が使える情報を増やす |
| Generation | 生成 | 足した情報をもとに、LLM が回答文をつくる |
押さえておきたいのは、RAG が文書の一部しか参照しないという点です。マニュアル全体を事前に覚えさせるのではなく、質問に近い数か所だけを毎回探して渡します。この性質が、RAG の強みにも弱みにもなります。
生成 AI 単体との違い
著書で使った例で比べます。人事評価のマニュアルがある会社で、社員が「評価に納得できないとき、異議申し立ての制度はありますか?」と聞いた場面です。
生成 AI 単体は、自社のマニュアルを読んだことがないので一般論しか返せません。RAG はマニュアルの該当箇所を探してから答えるので、「当社には制度があります」と言い切れます。
| 生成 AI 単体 | RAG | |
|---|---|---|
| 答えのもと | 学習済みの知識(Web、書籍、論文など) | 学習済みの知識と、検索した社内文書 |
| この質問への答え | 制度がある企業は多い、という一般論 | 自社の制度の有無と手続き |
| 情報を新しくするには | モデルの更新を待つ | 検索対象の文書を差し替える |
| 根拠の確かめ方 | どの資料にもとづく答えか分からない | 参照した文書の箇所を回答と一緒に出せる |
LLM が知らない情報を、著書では 2 つに分けて考えています。1 つは時間のずれで、学習を終えた時点(ナレッジカットオフ)より後の出来事は知りません。多くのチャット AI はこれを Web 検索で補っていて、Web 検索も、検索対象がインターネットである RAG の一種と見なせます。
もう 1 つは場所のずれです。社内の業務手順や過去の提案書のように公開されていない情報は、モデルの開発元も集めようがありません。社内向けの RAG が埋めるのは、主にこの穴です。
モデルを学習させ直す方法とも違います。RAG はモデルに手を入れず、プロンプトの中で情報を渡して、それを知っているかのように答えさせます。このやり方は In-Context Learning と呼ばれ、RAG はその一種です。
RAG の仕組み:基本の 4 ステップ
もっとも基本的な RAG(Naive RAG)は、次の 4 ステップで動きます。精度を上げるための手法はたくさんありますが、ほとんどはこの 4 ステップのどこかに手を加えたものです。
- データの格納:文書をチャンク(例えば 200 字ごとの塊)に分け、それぞれをベクトル(意味を表す数値の並び)に変換して、ベクトル DB に入れておく
- 質問の受け取り:利用者の質問(クエリ)を受け取る
- 類似検索:質問もベクトルに変換し、意味の近いチャンクを上位 k 件(top-k)取り出す
- 回答の生成:質問と取り出したチャンクを 1 つのプロンプトにまとめ、LLM に回答させる
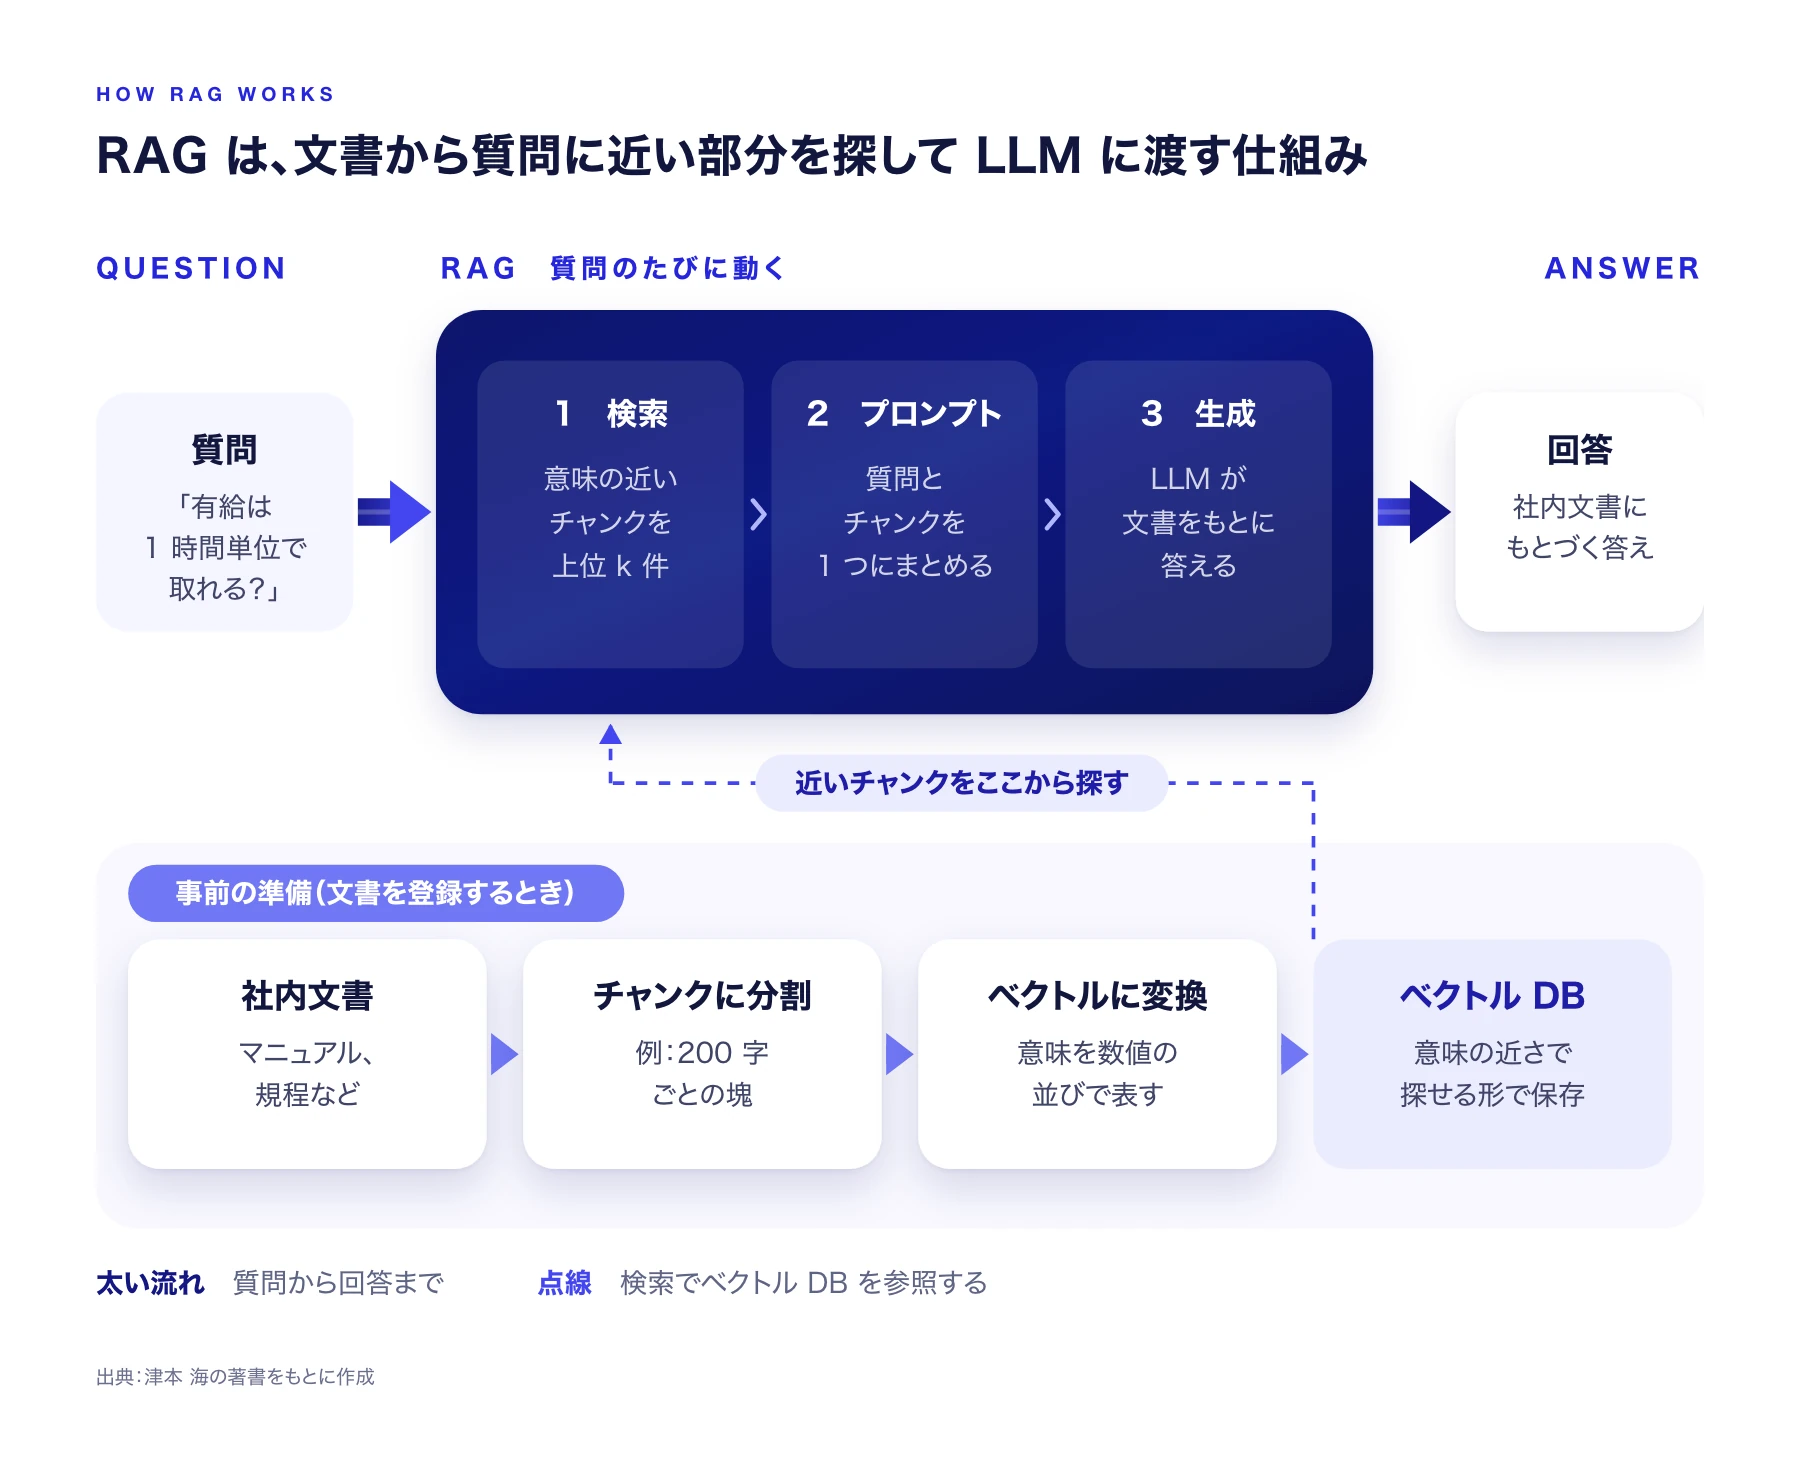
上の濃紺の部分は質問のたびに動く処理、下の帯は文書を登録するときに 1 回だけ行う準備です。検索ではベクトル DB の中から意味の近いチャンクを探すので、質問と文書で言い回しが違っていても見つけられます。
最後の生成で LLM に渡すプロンプトは、例えば次のような形です(著書の例を短くしたもの)。
以下の context に基づいて user_query に答えてください。
context に書かれていないことは推測せず、「分かりません」と答えてください。
<user_query>(利用者の質問)</user_query>
<context>(検索で選ばれたチャンク)</context>
つまり RAG の中身は「必要な情報をプロンプトに入れてもらった LLM」です。指示を書き換えれば、顧客データを参照する問い合わせ窓口にも、過去の議事録に質問できるシステムにもなります。
検索の細かい設定も精度を左右します。著書では、top-k が 1 件だと離れた場所にある情報を組み合わせられないため、5 件以上を標準としています。製品名や型番のように文字が完全に一致することが大事な語は、意味の近さよりキーワードで探すほうが取りこぼしにくいので、両方を組み合わせるハイブリッド検索もよく使われます。
RAG の弱点:一部しか参照しないこと
RAG は検索で選んだ一部しか LLM に渡さないため、全体を読まないと答えられない質問が苦手です。「この資料を要約して」「目次のない長い報告書から目次案をつくって」といった依頼がその例です。検索が外れたときも、LLM は答えの材料がないまま回答することになります。
代わりに、文書を丸ごとプロンプトに入れる方法もあります。いまの LLM は一度に扱える量(コンテキストウィンドウ)が大きく、Anthropic は 2024 年 9 月の記事で、知識ベースが 20 万トークンより小さければ RAG を使わず全体をプロンプトに入れればよいと書いています。ただし入れる量が増えるほど API の費用はかさみますし、長い入力の中ほどにある情報はうまく使われにくいという研究報告もあります。
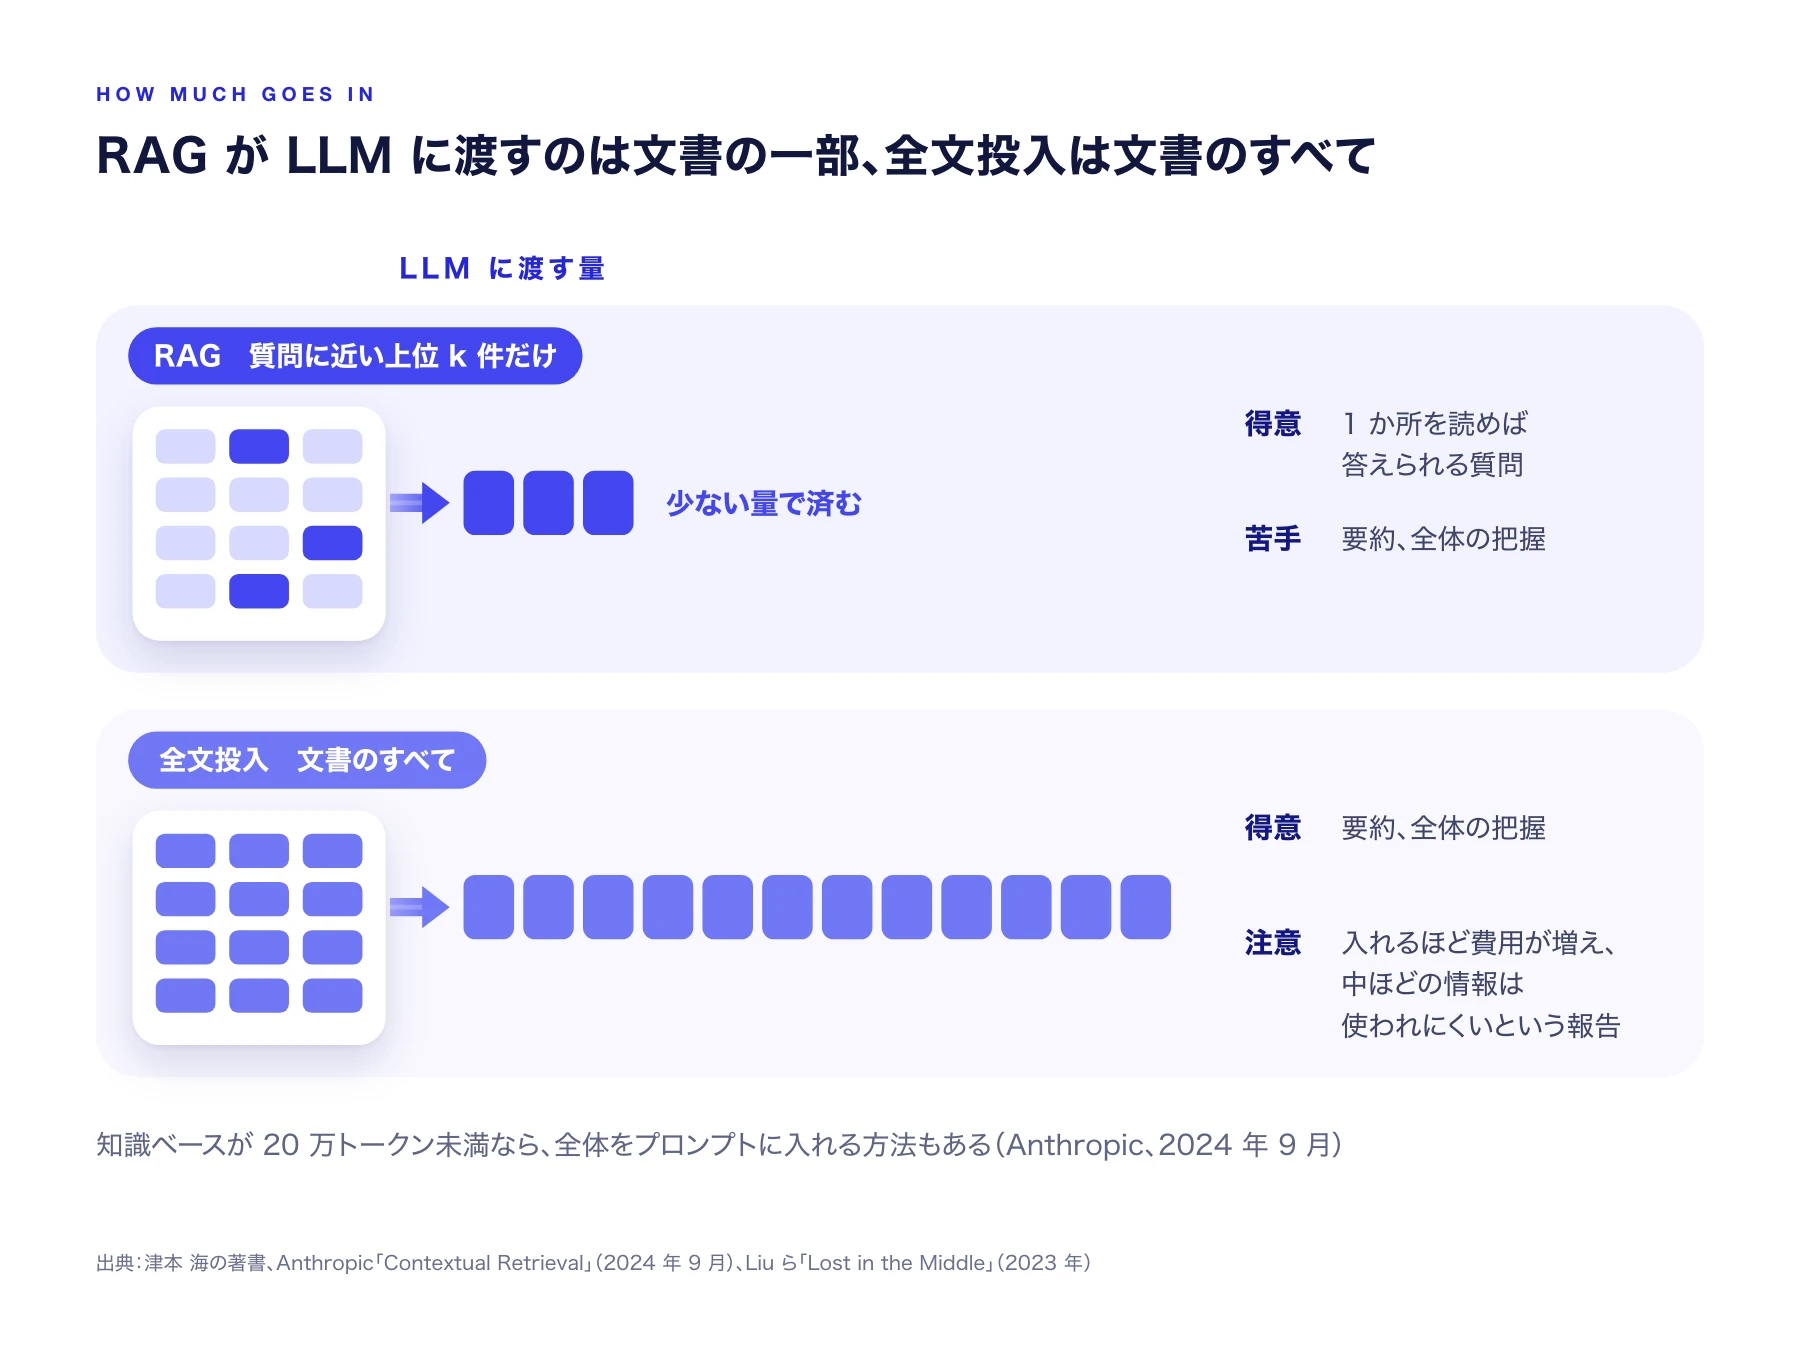
RAG は渡す量が少ないぶん費用を抑えられますが、要約のような全体を見る質問には向きません。全文投入はその逆で、どちらを使うかは答えさせたい質問で決まります。
私たちが相談を受ける中でも、「RAG を入れたい」という依頼の中身が、実は全文を読ませないと実現できない体験だったということは珍しくありません。手段を決める前に、どんな質問に答えさせたいのかを書き出してみてください。
向いている業務、向かない業務
RAG が力を出すのは、答えが文書のどこかに文章で書いてあり、質問に近い数か所を読めば答えられる業務です。全体の把握、数値の計算、個人ごとのデータの照会は、RAG だけでは無理があります。著書で整理したユースケースを、相性ごとに並べました。
| 業務 | 相性 | 補足 |
|---|---|---|
| 社内規程やマニュアルへの質問 | 向いている | 見出しが整理され、1 か所で話が完結している文書ほど精度が出やすい |
| 社内のファイルから目的の資料を探す | 向いている | 回答文より、参照元ファイルの候補を並べるほうが使いやすいこともある |
| アンケートの自由記述から話題を拾う | 向いている | 「匂いへのコメント」のように、言い回しが違っても意味で拾える |
| お客様向けの問い合わせ対応 | 工夫が必要 | 金額など誤りが許されない内容は、用意した回答や URL を AI に選ばせるか、人が確認してから返す |
| 画像の多いマニュアルへの質問 | 工夫が必要 | 画像の内容をテキストに直す前処理か、画像を扱えるマルチモーダル RAG が要る |
| 文書全体の要約や構成の把握 | 別の手段 | 全文を LLM に渡す方法のほうが得意 |
| 売上などの数値の集計 | 別の手段 | LLM に Python のコードを書かせて計算させる |
| 個人の購入履歴や配送状況への回答 | 別の手段 | 意味の近さで探すと別の人のデータを拾う危険がある。ログイン情報で本人のデータを引いて渡す |
最後の行は見落とされがちです。「私が買った商品はいつ届きますか」という質問と、その人の注文データは、意味が近いとは限りません。こういうデータは検索させるのではなく、システムで確実に特定してからプロンプトに入れます。
導入の最初に決めること
RAG の導入でつまずく会社の多くは、ツール選びから始めています。著書では、最初に決めるのはユースケース(誰が、どんな場面で、何を聞くか)と、検索させるデータだと書きました。使う人が変われば質問の言葉が変わり、どこまで答えられれば合格とするかも変わるからです。
精度の目安として、著書では業務で使うには 80% 程度以上が必要としています。一方で、データやユースケースと合わないツールを選ぶと 30% を切る企業も少なくありません。最初は、見出しの整ったテキスト中心の文書のように、シンプルな RAG でも精度が出やすい業務から始めるのが近道です。
試すだけなら、チャット AI に文書を登録して参照させる機能や、Dify のようなノーコードツールで足ります。Dify ではチャンクの分け方や検索方法も設定できます。画面や検索の仕組みまで作り込みたくなったら、自社開発を検討します。
精度が出ないときの原因の探し方は「RAG の精度が上がらない原因と対策」に、Excel や PowerPoint を検索できる形に直す方法は「RAG のためのデータ前処理」にまとめました。仕組みから精度向上の施策の選び方、Python での実装までを約 6 時間で学ぶ場として、株式会社スニフアウトは RAG技術研修 を開いています。
まとめ
- RAG は、検索した文書の一部をプロンプトに入れて LLM に答えさせる仕組みで、モデルの再学習ではない
- 基本は「格納、質問、類似検索、生成」の 4 ステップ。精度を上げる手法は、このどこかに手を入れたもの
- 文書の一部しか見ないので、全体の要約や数値の集計、個人データの照会には別の仕組みを組み合わせる
- 導入はツール選びより先に、ユースケースと検索させるデータを決める
よくある質問
RAG とファインチューニング(追加学習)は何が違いますか?
RAG に登録した社内文書は、AI に学習されますか?
RAG の回答精度はどのくらい出ますか?
文書を全部 LLM に読ませれば、RAG はいらないのではないですか?
この記事に関連するサービス
東京大学大学院 複雑理工学専攻卒業。理論物理学・ヒューマンインターフェースを専門とし、大手化粧品メーカー・ゲーム会社で AI/機械学習の開発に従事。2022年11月に株式会社スニフアウトを創業。RAG と AI エージェントの解説書を執筆している。
あわせて読みたい記事
 RAG の評価は、現場の人が入れる質問と理想の回答の組で正答率を出し、外れた原因を検索、生成、データに分けるところまで行います。質問集の項目と質問の種類、RAGAS の指標、LLM-as-a-Judge の注意点を説明します。
 RAG のデータ前処理は、Excel や PDF、PowerPoint、画像の情報を、検索で見つかり LLM が読み違えないテキストに直す作業です。形式ごとの崩れと直し方、チャンク分割までの 6 つの手順、自動化の考え方をまとめました。
 クラリフィケーションは、RAG への質問があいまいで答えが一つに決まらないとき、AI がユーザーに聞き返して条件を補ってもらう手法です。いつ聞き返すか、どう聞くか、効果の測り方までを解説します。