
- TOP
- スニフアウトAIメディア
- RAG
- Agentic Document Extraction(ADE)とは?OCRとの違い
Agentic Document Extraction(ADE)とは?OCRとの違い
ADE は、資料を文章・表・図・画像の領域に分け、領域ごとに読み方を変えて LLM が使えるテキストにする抽出の方法です。OCR との違い、RAG の精度に効く理由、変換後に人がやることを解説します。
目次
Agentic Document Extraction(ADE)とは、AI エージェントの仕組みを使って文書を読み取る方法です。ページを文章・表・図・画像の領域に分け、領域ごとに合った読み方を選んで、最後に 1 つのテキストや構造化データにまとめます。文字を写すだけの OCR と違い、表の行と列やフローチャートの分岐のように、人が図から読み取っていた意味までテキストに残せます。
RAG の回答精度が上がらないとき、原因は元の資料の側にあることが多いです。これまで受けてきた RAG の精度の相談でも、最も大きな原因は、元のデータが RAG で読める形になっていないことでした。ADE は、その読める形を作るための手段です。
ADE という言葉の 2 つの意味
ADE は、考え方の名前としても、製品の名前としても使われています。
| 使われ方 | 指しているもの |
|---|---|
| 考え方としての ADE | AI エージェントが文書の要素を一つずつ見分け、それぞれに合った方法で解釈しながら変換する抽出の方法 |
| 製品名としての ADE | 米 LandingAI 社が提供する文書抽出のサービス Agentic Document Extraction |
この記事では、まず考え方としての ADE を説明し、後半で LandingAI の製品を公式の情報で確かめます。日本ではまだあまり知られていない言葉ですが、社内の資料を RAG や AI エージェントに読ませる企業ほど、効き目の大きい考え方です。
OCR や文字の抜き出しとの違い
一般的な RAG の仕組みに Excel や PowerPoint、PDF を入れると、取り出せた文字だけが並び、画像の中の文字や図の意味は捨てられることが多いです。OCR を使えば画像の中の文字は読めますが、文字と文字の関係までは取り出せません。表なら縦と横の対応がずれ、ある行の数字が隣の行の項目に結びついてしまうことがあります。
要素ごとに比べると、次のようになります。
| 資料の要素 | 文字だけを抜き出した場合 | ADE で変換した場合 |
|---|---|---|
| 文章 | ほぼそのまま残る | OCR なども使って正確に文字にする |
| 表 | 行と列の対応が崩れることがある | 行と列を保った表や CSV、JSON にする |
| グラフ | 数字と項目がばらばらになる | 数字と項目の対応を保った構造化データにする |
| フローチャート | 箱の中の言葉が並ぶだけになる | 矢印と条件分岐を保った手順の文章や、Mermaid のような記述にする |
| 写真・図版・アイコン | 無視される | 何を示しているかを説明する文章にする |
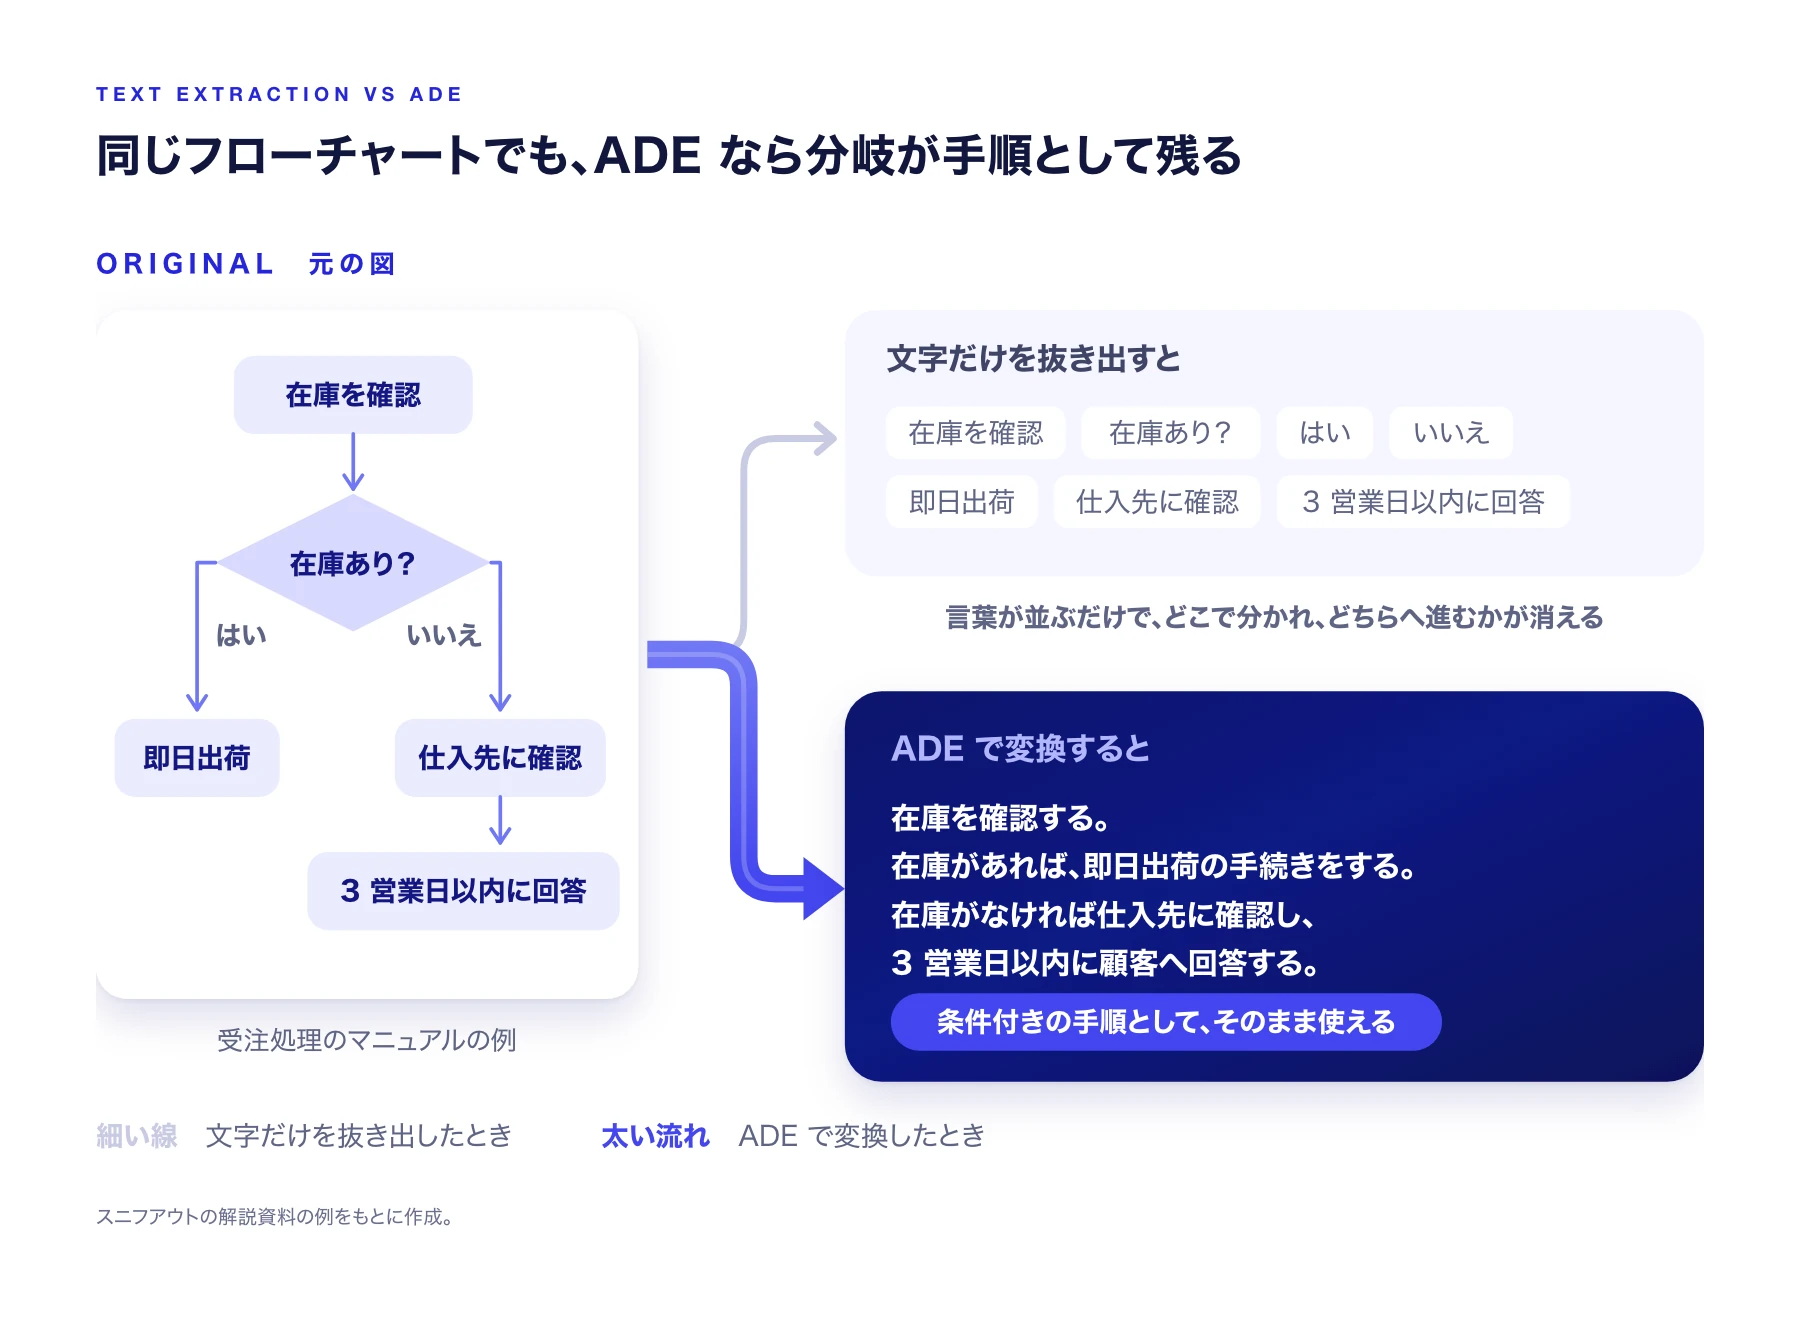
文字だけを抜き出すと、「在庫あり?」「はい」「いいえ」が並ぶだけで、どちらへ進むかが消えます。ADE で変換すると、在庫の有無で処理が分かれる条件付きの手順になり、AI エージェントの手順書としてそのまま使えます。
ADE は、人が図や画像から読み取っていた意味まで解釈してテキストにします。ここが OCR との一番大きな違いです。OCR がなくなるわけではなく、ADE の中で文章の領域を読む部品として使われます。
ADE が資料を読む流れ
ADE の処理は、大きく 3 つの段階に分かれます。
- 領域を見分ける:ページを領域に分け、それぞれが文章・表・グラフ・フローチャート・画像のどれかを特定する
- 読み方を振り分ける:振り分け役の AI が、領域ごとに OCR で文字を起こすか、構造の認識で行と列や矢印の関係を取り出すか、画像の認識で意味を読み取るかを決める
- 1 つにまとめる:統合役の LLM が、領域ごとの結果を読む順に並べ、1 つのテキストにする
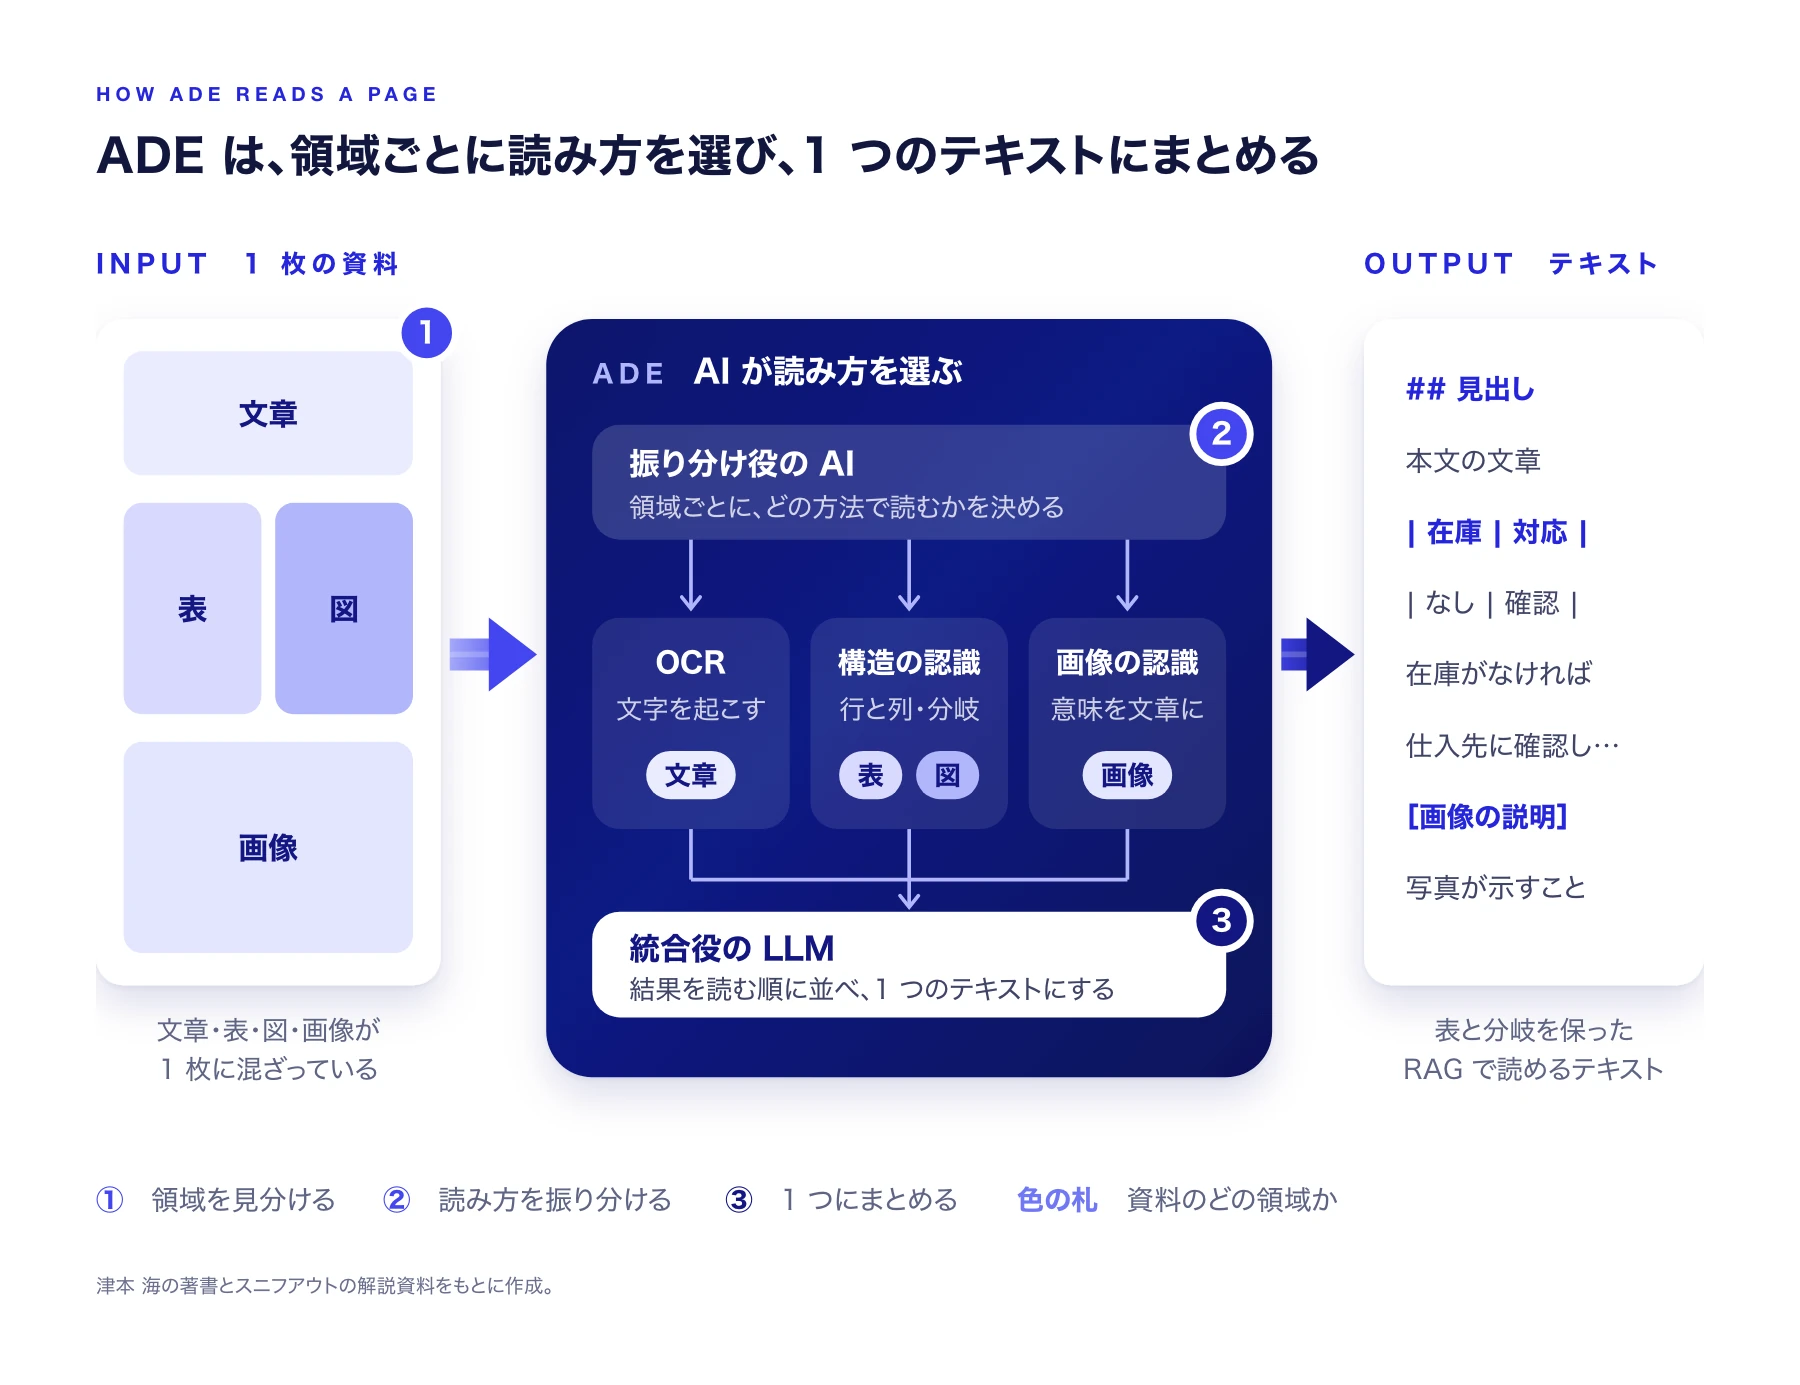
どの領域をどう読むかは、AI が資料ごとに判断しながら進めます。図の中の色の札は、左の資料のどの領域をどの読み方が受け持つかを示しています。Agentic(エージェント的)と呼ばれるのはこのためです。
実装は簡単ではありません。どの要素をどう解釈させるのが最適かは、市場でもまだ確立していません。仕組みによって読み取りやすい資料とそうでない資料があるので、自社の資料で数件試してから選ぶのが確実です。
RAG の精度に効く理由
RAG は、検索で拾ったテキストの断片(チャンク)を読んで答えます。資料を取り込む段階で落ちた情報は、検索にも回答にも出てきません。表の縦横が崩れていれば、検索で正しい箇所を拾っても、回答に使う数字が隣の行のものになります。
厄介なのは、AI が「この表は読めませんでした」とは言わないことです。読めた断片をつなぎ合わせ、もっともらしい回答を作ります。間違いが表に出にくいので、利用者が気づかないまま誤った回答が使われてしまいます。プロンプトやモデルを変えても直らないときは、まず AI が実際に読んだテキストを開いて確かめてください。
逆に、資料を一度うまくテキストにできれば、回答の段階で元の画像を見なくても答えられる問いが多くなります。LandingAI は、同社の ADE が当時の DPT-2 というモデルで出力した Markdown と JSON だけを LLM に渡し、元のページの画像を見せずに文書の読解問題(DocVQA の検証用データ 5,331 問)に答えさせたところ、5,286 問(99.16%)に正答したと公表しています(2025 年 11 月 12 日)。同社による検証で、テスト用データでの評価は今後の課題としています。テキストだけで答えるという点は、RAG の前提と同じです。
もう一つの効き目は、根拠を確かめやすくなることです。LandingAI の ADE のように、抜き出した内容が元の資料のどのページのどの位置にあったかを示す情報(グラウンディング)を出力に付ける製品があります。私が企業の RAG 導入を支援した際に測ったところ、ボタンを押して参照元を確かめていた利用者は全体の 20% にも届きませんでした(前掲書 2-11)。位置の情報があれば、回答の横に元のページの該当箇所を出す画面が作れます。
精度が上がらない原因の全体像は「RAG の精度が上がらない原因と対策」に、Excel や PDF の前処理全般は「RAG のためのデータ前処理」にまとめています。
LandingAI の Agentic Document Extraction(2026 年 11 月時点)
製品としての ADE を、LandingAI の公式情報で確かめておきます。2026 年 9 月 8 日に第 2 世代が発表され、API と出力の形式が作り直されています。それより前の解説記事は、古い仕様のまま書かれている可能性があります。
| 項目 | 内容 |
|---|---|
| 位置づけ | 文書を信頼できる構造化データに変える文書処理の基盤(公式ドキュメント) |
| 主な API | Parse(文書を構造化する)、Extract(スキーマを決めて項目を抜き出す)、Classify(文書の種類を分ける)、Split(複数の文書を分ける)、Ground(抜き出した値の位置を示す) |
| Parse の出力 | 読む順に並んだ Markdown、ページとブロックの階層構造(表はセルまで)、ブロックごとの位置(バウンディングボックス) |
| 読み取りのモデル | DPT-3 Pro と、プレビュー中の DPT-3 Verity。Pro は行の単位、Verity は単語の単位まで位置を示す(第 2 世代の発表) |
| 対応するファイル | PDF と画像、DOCX や PPTX などの Office 文書、XLSX や CSV などの表計算のファイル |
| 使い方 | ブラウザで試せる Playground、API、CLI。Python と TypeScript のライブラリも用意されている |
| 動かす場所 | 米国と EU のクラウド、利用企業の VPC、オンプレミス(第 2 世代の発表) |
更新の頻度は高く、変更履歴では v2 の API が 2026 年 7 月 24 日に一般提供になり、その後も表計算のファイルへの対応などが続いています。料金や細かい仕様は、使う前に公式の情報で確かめてください。
変換したあとに人がやること
ADE で変換すれば終わり、というわけではありません。変換したあとは、次の 5 つを進めることをお勧めしています。
- AI が読んだテキストを数件、目で確かめる:表の縦横や図の矢印の関係が、変換後のテキストにも残っているかを見る
- 業務の担当者と読み合わせる:手順の抜けや解釈の誤りを、その業務をしている人に直してもらう
- 書かれていない判断を書き足す:ベテランが頭の中で使っている例外の扱いや判断の基準は、どの資料にも載っていない
- 正本と更新の担当を決める:元の資料が更新されたら変換し直す。誰がいつ更新するかを決めておかないと、古い変換結果が残り続ける
- 評価用の質問で、変換の前と後を比べる:同じ質問への回答が良くなったかを数字で確かめる(進め方は「RAG の評価方法」)
3 つ目は ADE の限界でもあります。ADE が変換できるのは、すでに存在する資料だけです。書かれていない知識は、どれだけ優れた変換の技術を使っても取り出せないので、インタビューなどで書き起こします。この考え方は「ナレッジギャップを埋めることが AI エージェントの精度を上げる」で詳しく扱っています。
もう一つ、変換したデータは元の資料から切り離された別の置き場になりやすく、更新のたびに作り直す手間もかかります。長い目で見れば、新しい手順を決めたら図だけで済ませず条件付きの手順を文章でも残す、会議の内容は文字起こしで残す、といった具合に、最初から AI が読める形で書く運用に変えていくのが本筋です。ADE は、すでに溜まった資料を一気に読める形にするための手段と考えるのがよいと思います。
スニフアウトの RAG Ready Converter
株式会社スニフアウトでも、この ADE の考え方で資料を RAG で読める形のテキストに変える RAG Ready Converter を提供しています。OCR、画像の認識、構造の認識を並行して走らせ、その結果を統合役の LLM が突き合わせて出力を決める構成で、特許を取得しています。
対応しているのは画像(.png、.jpg)、Excel(.xlsx)、Word と PDF(.docx、.pdf)、PowerPoint(.pptx)で、画面からの操作のほか、API や Dify のプラグインからも使えます。建築図面や機械製図は、現時点では十分な精度が出ない場合があります。支援の中では、数万ページ、数千冊分のカタログを約 3 日で AI が読める形式に変換した例がありました。人の手で整え直していたら、1 年以上かかる見込みだった作業です。
変換の前に、どの資料を対象にし、変換後にどう評価するかを決めておくと、効果を測りやすくなります。RAG の前処理や精度の評価を社内で回せるようにしたい場合は、RAG技術研修 で扱っています。
まとめ
- ADE は、資料を領域ごとに読み分け、表の構造や図の意味まで含めて 1 つのテキストにまとめる抽出の方法です
- OCR は文字を読む部品で、ADE はその上で、何をどう読むかを AI が判断します
- RAG の精度が上がらないときは、プロンプトやモデルより先に、AI が実際に読んだテキストを確かめてください
- 変換したら、業務の担当者と読み合わせ、書かれていない判断を書き足し、正本と更新の担当を決めます
- 製品の仕様は 2026 年に大きく変わっています。LandingAI の ADE を使うなら、第 2 世代の公式ドキュメントを基準にしてください
よくある質問
Agentic Document Extraction(ADE)とは何ですか?
ADE と OCR は何が違いますか?
ADE で資料を変換すれば、RAG の精度は上がりますか?
LandingAI の ADE はどんな形で結果を返しますか?
ADE で変換したら、そのまま RAG に入れてよいですか?
この記事に関連するサービス
東京大学大学院 複雑理工学専攻卒業。理論物理学・ヒューマンインターフェースを専門とし、大手化粧品メーカー・ゲーム会社で AI/機械学習の開発に従事。2022年11月に株式会社スニフアウトを創業。RAG と AI エージェントの解説書を執筆している。
あわせて読みたい記事
 クラリフィケーションは、RAG への質問があいまいで答えが一つに決まらないとき、AI がユーザーに聞き返して条件を補ってもらう手法です。いつ聞き返すか、どう聞くか、効果の測り方までを解説します。
 RAG(検索拡張生成)は、LLM が答える前に社内文書を検索し、見つけた一部をプロンプトに入れて回答させる仕組みです。モデルの再学習とは別物です。4 つの手順、生成 AI 単体との違い、向く業務と向かない業務を図で説明します。
 RAG の評価は、現場の人が入れる質問と理想の回答の組で正答率を出し、外れた原因を検索、生成、データに分けるところまで行います。質問集の項目と質問の種類、RAGAS の指標、LLM-as-a-Judge の注意点を説明します。